Cómo busca información la IA: RAG, grounding y su impacto en el SEO
- Nivel: Avanzado
- #AI Search
- #GEO
- #Avanzado
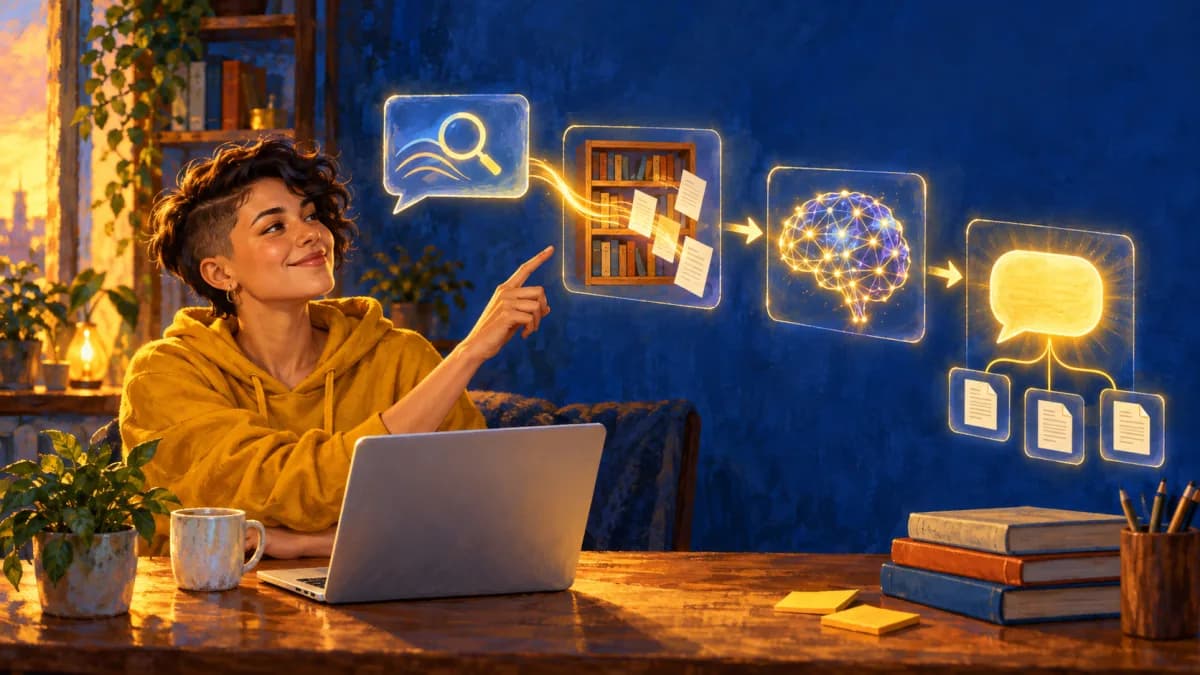
Un asistente de IA responde de dos formas: de memoria, con lo que aprendió en el entrenamiento, o consultando fuentes en el momento. RAG (generación aumentada por recuperación) y grounding son los nombres técnicos de la segunda forma: el sistema busca páginas, selecciona fragmentos y el modelo escribe la respuesta apoyándose en ellos. Para el SEO, esto significa que importa ser rastreable, indexable y claro en los fragmentos clave, como explicamos en SEO, AEO y GEO.
Resumen rápido
- El entrenamiento es memoria fija, con una fecha de corte. La recuperación es una consulta en vivo a una base de documentos o a la web. Las citas que ves vienen de la recuperación.
- Google describe RAG como la técnica (también llamada grounding) en la que el modelo usa páginas recuperadas del índice de búsqueda para generar la respuesta y mostrar enlaces.
- Una pregunta puede convertirse en varias búsquedas (query fan-out). Tu página puede ser recuperada por una subpregunta a la que nunca apuntaste.
- Cómo selecciona y ordena fragmentos cada empresa no es público. Lo que sí puedes hacer es cuidar lo verificable: acceso, indexación, claridad y actualidad.
- Para Google, no existe un marcado ni un archivo especial para entrar en las respuestas de IA, y la cita nunca está garantizada.
Cómo leer este artículo: si eres principiante, lee "¿Cuál es la diferencia entre lo que la IA aprendió en el entrenamiento y lo que busca?" y "¿Cómo se convierte la pregunta en respuesta?", y salta los recuadros técnicos. Si ya trabajas en SEO, ve al fan-out, a la sección sobre fragmentos y a la tabla de implicaciones.
¿Cuál es la diferencia entre lo que la IA aprendió en el entrenamiento y lo que busca?
En el entrenamiento, el modelo absorbe patrones de una enorme masa de texto y los guarda en sus parámetros, sin acceso a páginas nuevas. En la recuperación, el sistema consulta una fuente externa en el momento de la pregunta y entrega los resultados al modelo, que los usa para responder. La segunda forma es la que permite citar fuentes y hablar de cosas recientes.
La idea viene de un trabajo académico. El artículo Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, de Patrick Lewis y colegas (publicado en 2020 y aceptado en la conferencia NeurIPS), combinó la memoria paramétrica de un modelo de lenguaje con una memoria externa, en este caso un índice denso de Wikipedia, y mostró mejoras en tareas que exigen conocimiento. Hoy, la documentación de productos como Gemini describe el mismo principio: la función de grounding con Google Search conecta el modelo con contenido de la web en tiempo real, para dar respuestas más allá de la fecha de corte del conocimiento y con citas.
En lenguaje sencillo: el entrenamiento es el examen que haces de memoria, solo con lo que estudiaste. La recuperación es el examen con consulta: abres el libro, encuentras el capítulo correcto y respondes mirándolo. El grounding es la regla de que la respuesta debe señalar la página del libro donde encontraste la información.
La consecuencia para el marketing es directa. Entrar en el entrenamiento de un modelo casi no lo controlas. Entrar en la recuperación depende de lo que controlas hoy: que la página sea accesible, que se encuentre para la subpregunta correcta y que tenga un fragmento que responda.
¿Qué son RAG y grounding?
RAG es la técnica de buscar documentos relevantes y dárselos al modelo antes de que responda. Grounding es el objetivo: anclar la respuesta en fuentes verificables. Google trata ambos como equivalentes. En su guía de optimización para funciones generativas, define RAG (también conocido como grounding) como la técnica que mejora la calidad, la precisión y la actualidad de las respuestas, apoyándose en los sistemas de ranking de la Búsqueda para recuperar páginas del índice y mostrar enlaces que sustentan la información.
En la práctica, esto explica por qué la página debe estar indexada y ser elegible para fragmentos destacados (snippets): las funciones generativas se apoyan en los sistemas de ranking y de calidad que ya existían.
Para quien ya trabaja en SEO: "RAG" es una arquitectura, no un producto. Cada empresa decide el índice (propio o de terceros), el número de documentos recuperados, el tamaño de los fragmentos, el reordenamiento y cómo se adjunta la cita. Solo las partes documentadas públicamente son citables. En el resto, lo que existe es inferencia a partir de pruebas.
¿Cómo se convierte la pregunta en respuesta?
El camino tiene cinco etapas. La documentación oficial confirma las de decisión, búsqueda y cita; la selección y el reordenamiento de fragmentos las empresas no los detallan.
- El sistema decide si necesita buscar. Según la documentación de web search de Anthropic, Claude busca cuando la solicitud involucra algo actual, cambiante o ajeno a su entrenamiento, y responde directamente cuando se trata de conocimiento estable. En Gemini, el modelo analiza la solicitud y determina si una búsqueda mejora la respuesta.
- Genera una o varias consultas. El modelo reformula la pregunta en búsquedas que el sistema ejecuta. La misma documentación de Anthropic dice que el proceso puede repetirse varias veces en una misma solicitud, y que las preguntas factuales simples suelen usar de 1 a 3 búsquedas, mientras que las investigaciones comparativas pueden usar 10 o más.
- Recupera candidatos de un índice. Puede ser el índice de Google (en Gemini y en las funciones de IA de la Búsqueda) u otro. No todas las empresas informan qué índice usan.
- Selecciona los fragmentos útiles. Aquí entran técnicas generales de RAG, como los embeddings y el reordenamiento (reranking). No hay documentación pública, por empresa, de pesos ni de criterios.
- Escribe la respuesta con citas. En el caso de Anthropic, cada cita incluye URL, título y hasta 150 caracteres del texto citado. En Gemini, las citas vienen como anotaciones que vinculan partes del texto con las fuentes.
Fíjate en que la cita es por fragmento: la respuesta señala un pasaje específico, no "el sitio". Una página buena pero con la respuesta enterrada tiende a perder contra una mediana con la respuesta bien ubicada en un bloque claro.
¿Qué es el query fan-out y por qué cambia la investigación de palabras clave?
El query fan-out es el conjunto de búsquedas relacionadas que el modelo genera al mismo tiempo para reunir más información. Google da un ejemplo en su guía: para "cómo arreglar un césped lleno de malezas", el fan-out puede incluir "mejores herbicidas para césped", "eliminar malezas sin productos químicos" y "cómo prevenir las malezas en el césped". Por eso una sola pregunta puede recuperar páginas muy distintas.
Para la investigación de palabras clave, la lección es cubrir los subtemas que una persona necesitaría resolver, y no solo la palabra principal. Detallamos la mecánica en query fan-out.
Hay un límite que el propio Google pone: crear una página para cada variación de una pregunta, sobre todo para manipular las respuestas, viola la política de spam de contenido a escala. Cubre los subtemas dentro de páginas útiles, en lugar de generar cientos de páginas casi idénticas.
Ejemplo hipotético: alguien pregunta "¿cuál es el mejor software de gestión para una clínica dental pequeña que gestione la facturación con seguros?". El sistema podría generar subconsultas como "software de gestión para clínica dental pequeña", "facturación a aseguradoras en software dental", "precio de software para clínicas dentales" e "integración con seguros". Una empresa con una página específica sobre facturación a aseguradoras, con la respuesta en un bloque corto al inicio y la fecha de actualización, puede ser la fuente de la segunda subconsulta aunque no posicione para la pregunta completa. Es una ilustración, no un registro real de consultas.
¿Cómo elige la IA qué fragmentos usar?
Nadie de afuera lo sabe con precisión. Lo que está documentado es que Google tiene un sistema de ranking de pasajes, descrito en la guía de sistemas de ranking como un sistema de IA usado para identificar secciones individuales ("pasajes") de una página y entender mejor su relevancia para la búsqueda. Para los asistentes en general, la descripción técnica común es cortar los documentos en fragmentos, convertirlos en vectores (embeddings), compararlos con la consulta y, a veces, reordenar los mejores.
En lenguaje sencillo: imagina que tu página es un libro y la IA tiene poco tiempo. No lee el libro entero, busca el párrafo que responde. Si cada sección abre con la respuesta, la encuentra rápido. Si la respuesta está repartida en cinco párrafos, es fácil que pase al libro de al lado.
Aquí hay una tensión. Google afirma, en la misma guía, que no hace falta fragmentar el contenido en pedacitos minúsculos para la IA, porque sus sistemas entienden varios temas en una página y muestran la parte relevante. Es decir, nada de "chunking" artificial. Pero las secciones con un título claro y una respuesta directa ayudan al lector y no cuestan nada. Lo detallamos en estructura de contenido citable por LLM.
¿Qué cambia para el SEO en la práctica?
Cambia el énfasis, no el fundamento. La tabla separa lo que está documentado de lo que es buena práctica.
| Aspecto | Qué se sabe | Qué hacer |
|---|---|---|
| Elegibilidad en Google | La página debe estar indexada y ser elegible para snippets; el sitio también debe estar incluido en el control de IA generativa de Search Console | Revisa la indexación y el control en la configuración de Search Console |
| Crawlers de IA | OpenAI documenta OAI-SearchBot (aparecer en la búsqueda de ChatGPT), GPTBot (entrenamiento) y ChatGPT-User (acciones del usuario) | Define en robots.txt quién puede acceder a qué; mira robots.txt y crawlers de IA |
| Actualidad | La API de búsqueda de Anthropic devuelve un campo page_age por resultado | Mantén visible la fecha de actualización y revisa los datos que cambian |
| Cita por fragmento | Las citas señalan pasajes (hasta 150 caracteres citados en el caso de Anthropic) | Abre cada sección con la respuesta directa |
| Cobertura de subtemas | El fan-out recupera páginas por subpreguntas | Responde las subpreguntas centrales, sin crear páginas casi duplicadas |
| Otros índices | Cada asistente usa un índice propio o de terceros y no siempre informa cuál | Cubre también Bing e IndexNow; mira Bing Webmaster e IndexNow para IA |
La documentación de OpenAI sobre sus crawlers trae tres detalles: los sitios que bloquean OAI-SearchBot no aparecen en las respuestas de la búsqueda de ChatGPT; bloquear GPTBot indica que el contenido no debe usarse en el entrenamiento; y un cambio en el robots.txt puede tardar cerca de 24 horas en surtir efecto. Son decisiones separadas: se puede aparecer en la búsqueda y negar el entrenamiento.
Para quien ya trabaja en SEO: ChatGPT-User, según OpenAI, no se usa para rastrear la web de forma automática, y las reglas del robots.txt pueden no aplicarse a él por ser activado por el usuario. Quien audita logs debe separar estos tres agentes en sus análisis, en lugar de tratar el "tráfico de bots de IA" como un bloque único.
¿Cómo auditar una página pensando en RAG?
Audita en el orden del pipeline. Cada paso es una etapa en la que la página puede ser eliminada antes de que se escriba la respuesta.
- Acceso. ¿El robots.txt y las reglas del servidor permiten los crawlers que te importan? Revisa los bloqueos por error.
- Indexación. ¿La página está indexada y sin
noindex? Confírmalo en Search Console con la inspección de URL. - Cobertura. Enumera de 5 a 10 subpreguntas que tendría una persona sobre el tema y verifica si la página, o el clúster, las responde.
- Fragmento. Reescribe las aperturas de las secciones con la respuesta primero, en 40 a 70 palabras.
- Actualidad. Actualiza datos, precios y fechas, y muestra la fecha de la última revisión.
- Prueba. Haz las preguntas en dos o tres asistentes, anota qué fuentes aparecen y qué le falta a tu página en comparación con las citadas. Repite cada mes. El AI Visibility de Contentor hace seguimiento, en las preguntas que elijas, de si ChatGPT cita tu marca (solo ChatGPT).
Para un flujo de optimización más amplio, mira SEO para AI Search.
Preguntas frecuentes
¿Qué es RAG, en una frase?
RAG es la técnica en la que el sistema busca documentos relevantes y se los entrega al modelo antes de que responda, para que la respuesta use información actual y pueda citar fuentes. El nombre viene de un artículo de 2020. Google usa el término como sinónimo de grounding en las respuestas de IA de la Búsqueda.
¿Debo preocuparme por el entrenamiento de los modelos o solo por la búsqueda?
Para la visibilidad inmediata, la búsqueda es lo que controlas: acceso, indexación y claridad de los fragmentos. Sobre el entrenamiento, puedes decidir si permites o no el uso de tu contenido, por ejemplo con GPTBot en el robots.txt, en el caso de OpenAI. Es una decisión estratégica separada, y bloquear el entrenamiento no impide aparecer en respuestas basadas en búsqueda.
¿Dividir el texto en bloques cortos ayuda a la IA?
Ayuda al lector y puede ayudar a la extracción, pero Google dice que no es necesario fragmentar el contenido solo para la IA. El mejor criterio es la utilidad: las secciones con un título claro y una respuesta directa funcionan para las personas y para los sistemas de recuperación.
¿RAG garantiza que la respuesta de la IA es correcta?
No. RAG mejora la probabilidad de que la respuesta se apoye en fuentes, pero el modelo aún puede interpretar mal un fragmento o citar una fuente que no respalda la afirmación. Por eso, al probar tu marca, abre los enlaces citados y comprueba que el fragmento realmente diga lo que afirma la respuesta.
Siguiente paso
Si aún no has revisado el acceso de los crawlers, empieza por robots.txt y crawlers de IA y luego escribe fragmentos extraíbles con estructura de contenido citable por LLM. Para el siguiente paso del camino avanzado, sigue con la auditoría GEO paso a paso. Si tu cuello de botella es producir las páginas que responden a las subpreguntas, genera artículos con IA en Contentor con títulos en forma de pregunta y respuesta directa.
Lee también:
Prepara tu contenido para las respuestas de IA
Crea briefings AEO/GEO, entidades, schema y artículos estructurados para Google AI Overviews, AI Mode y el SEO tradicional.
Probar Contentor gratisRefuerza tu autoridad para la búsqueda con IA
Combina contenido citable con backlinks contextuales en sitios verificados para reforzar la confianza, el descubrimiento y la autoridad temática.
Ver backlinks contextuales